implementasi RAG untuk perusahaan
RAG untuk Knowledge Base Perusahaan: Membuat Jawaban AI Lebih Akurat
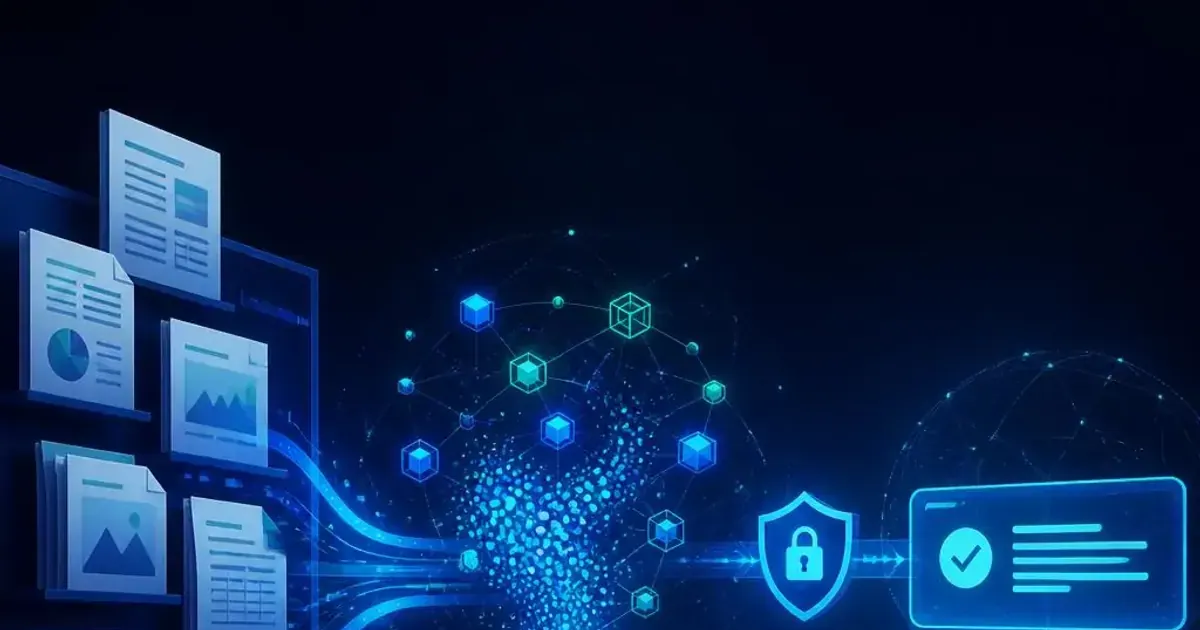
Jawaban langsung: Implementasi RAG perusahaan adalah proses mengubah dokumen internal menjadi knowledge base yang dapat dicari AI. Kunci keberhasilannya ada pada chunking dokumen, metadata, retrieval yang terkontrol, dan audit log sumber jawaban.
Panduan pembaca
Istilah penting dalam artikel ini
- RAG
- Retrieval-Augmented Generation atau metode yang mengambil sumber relevan sebelum AI menyusun jawaban.
- Chunking
- Proses memecah dokumen menjadi potongan bermakna agar mudah dicari dan dipakai AI.
- Embedding
- Representasi numerik dari teks yang membantu sistem menemukan kemiripan makna.
- Retrieval
- Proses mengambil potongan dokumen paling relevan untuk menjawab pertanyaan.
- pgvector
- Ekstensi PostgreSQL untuk menyimpan dan mencari representasi vektor.
Bagikan artikel ini ke founder, COO, atau tim implementasi Anda.
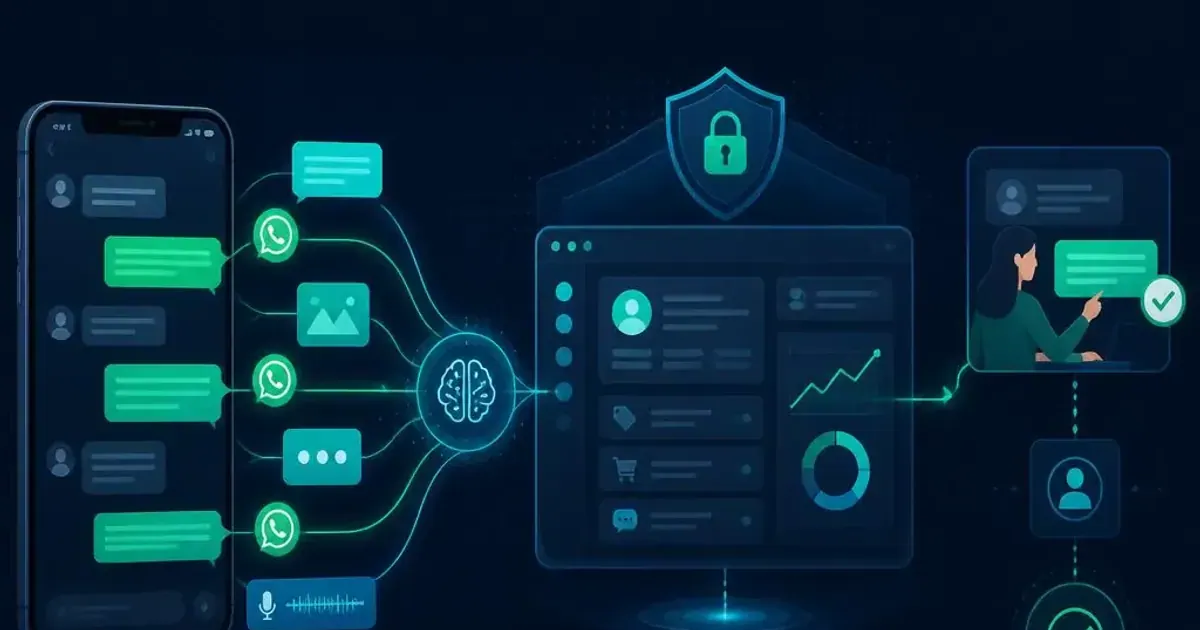
Dokumen rapi
Owner dan versi membuat sumber bisa dipercaya.
Konteks relevan
Chunk dipilih berdasarkan makna dan akses.
Audit trail
Setiap jawaban dapat ditelusuri dan diperbaiki.
- Mulai dari inventory dokumen, owner, versi, dan klasifikasi akses.
- Chunk berdasarkan batas makna dan keputusan, bukan karakter semata.
- Filter retrieval memakai metadata peran dan tingkat kerahasiaan.
- Catat chunk sumber, skor, jawaban, dan koreksi manusia.
RAG tidak menghapus kebutuhan governance; ia membuat kualitas governance dokumen terlihat dari kualitas jawaban.
Ringkasan
Implementasi RAG perusahaan mengubah dokumen internal menjadi knowledge base yang dapat dicari AI. RAG (Retrieval-Augmented Generation) tidak otomatis menghapus halusinasi; hasilnya bergantung pada document inventory, chunking bermakna, metadata akses, retrieval yang terkontrol, dan audit log sumber jawaban.
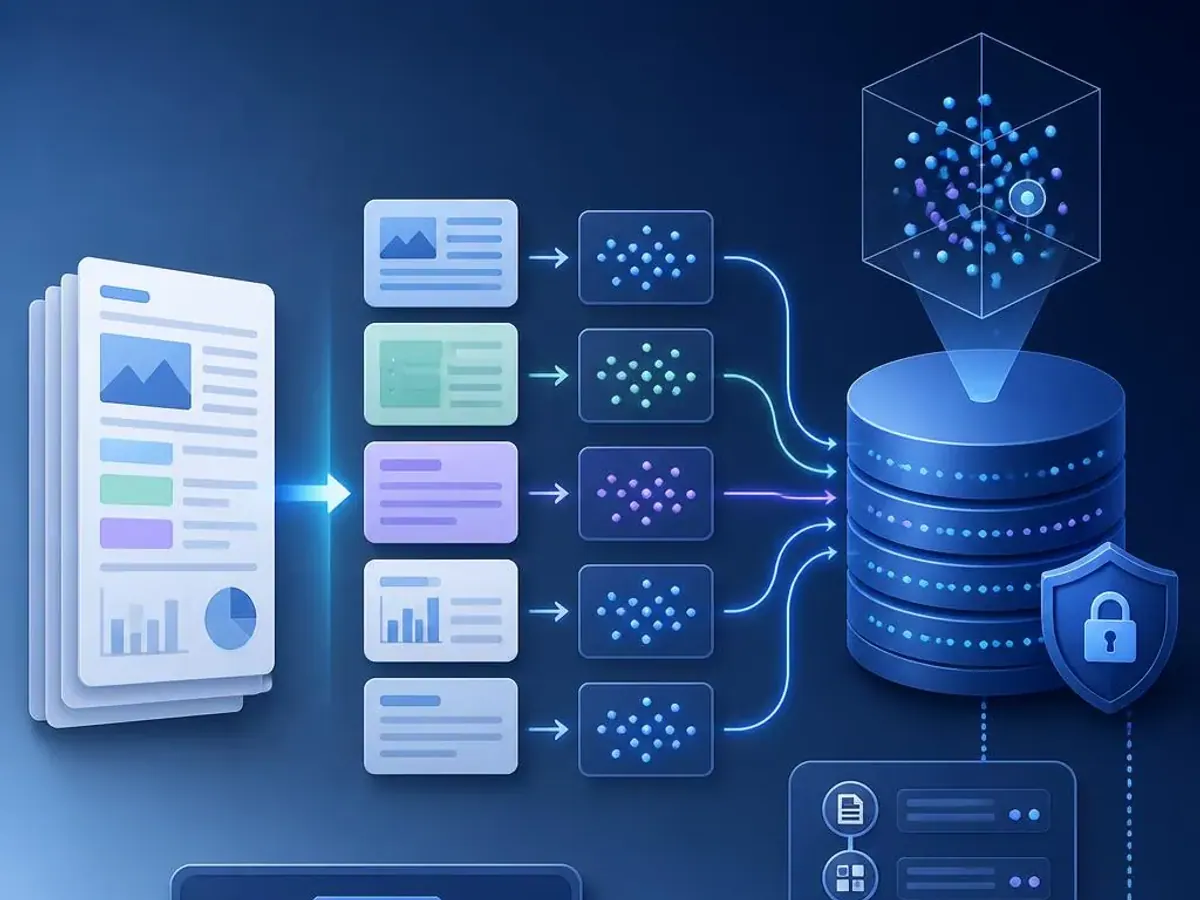
Mekanisme: dokumen menjadi konteks
Mulai dari dokumen yang benar-benar dibutuhkan untuk satu use case—misalnya SOP layanan, kebijakan retur, daftar produk, dan FAQ untuk CS. Setiap dokumen perlu owner, versi, tanggal pembaruan, kategori, serta klasifikasi kerahasiaan.
Chunking adalah pemecahan dokumen menjadi potongan bermakna; ikuti heading, prasyarat, langkah, pengecualian, atau pasal, bukan jumlah karakter semata. Syarat refund, dokumen pendukung, dan pengecualian sebaiknya tidak tercampur dalam potongan acak.
Embedding, yaitu representasi numerik teks untuk mencari kemiripan makna, harus diproses konsisten dan diberi versi. Saat pertanyaan masuk, retrieval memahami intent, memfilter koleksi berdasarkan peran, lalu mengambil chunk paling relevan.
Jawaban idealnya memuat simpulan, bukti, dan batasan; jika bukti kurang, sistem mengatakan informasi belum cukup.
Guardrail, schema, dan audit
Metadata bukan pelengkap. Simpan judul dan versi dokumen, owner/departemen, tanggal update, jenis dokumen, serta level akses pada setiap chunk. pgvector—ekstensi PostgreSQL untuk pencarian vektor—dapat disusun bersama tabel dokumen, chunk, dan audit.
Tabel audit sebaiknya merekam pertanyaan, chunk terambil, skor retrieval, template, jawaban final, dan edit manusia.
Filter retrieval harus mengikuti identitas atau peran pengguna agar frontliner tidak menerima dokumen finance atau legal. Audit log juga menjadi loop perbaikan: koreksi supervisor menunjukkan chunk terlalu panjang, dokumen usang, atau policy jawaban yang perlu diperjelas.
Governance ini menekan risiko, tetapi tidak menjamin AI bebas kesalahan.
Perbandingan Pendekatan Knowledge Base
| Pendekatan | Keunggulan | Kelemahan | Use case |
|---|---|---|---|
| Prompt manual tanpa retrieval | Cepat untuk demo | Tidak bersumber dan mudah halusinasi | Eksperimen awal |
| FAQ statis | Murah dan sederhana | Sulit menangani pertanyaan bercabang | Pertanyaan sangat terbatas |
| RAG + pgvector | Jawaban lebih kontekstual dan bisa diaudit | Perlu dokumen rapi dan metadata baik | SOP dan knowledge base internal |
| Fine-tuning tanpa governance dokumen | Terlihat canggih | Sulit update dan sulit telusur sumber | Kasus khusus tertentu |
Skenario knowledge base SOP
Perusahaan multi-cabang ingin membantu CS menjawab refund, jadwal layanan, dan dokumen pendukung. Sebelum RAG, staf membuka PDF lama atau bertanya ke supervisor.
Setelah inventory, hanya SOP terbaru yang aktif; tiap bagian menjadi chunk logis dengan metadata versi. Sistem menjawab dengan menyebut kebijakan yang dipakai.
Saat refund berubah, versi baru diaktifkan dan versi lama dinonaktifkan. Audit log kemudian memeriksa apakah ada jawaban yang masih mengambil chunk lawas.
Contoh ROI knowledge base RAG
| Komponen | Asumsi | Perhitungan | Dampak |
|---|---|---|---|
| Waktu pencarian SOP | 10 menit menjadi 2 menit | Hemat 8 menit per query | Tim lebih cepat mengambil keputusan |
| Konsistensi jawaban | Jawaban bersumber | Diukur dari penurunan koreksi manual | Kesalahan kebijakan turun |
| Onboarding staf baru | Lebih cepat memahami SOP | Dihitung dari waktu supervisi yang berkurang | Produktivitas awal naik |
| Manfaat utama | Auditability | Nilai tinggi untuk compliance | Kepercayaan pengguna meningkat |
Framework implementasi
- Pilih satu use case dan inventaris dokumen dengan owner, versi, serta klasifikasi akses.
- Lakukan semantic chunking mengikuti struktur keputusan dan beri metadata pada setiap chunk.
- Rancang schema dokumen, chunk, vector search, dan hak akses; pgvector adalah salah satu opsi.
- Log pertanyaan, retrieval, jawaban, dan koreksi manusia; gunakan hasilnya untuk QA dan pembaruan dokumen.
Kesimpulan
Kesimpulannya, RAG yang dapat dipercaya lahir dari sumber yang rapi dan jejak keputusan yang bisa diaudit, bukan dari model yang paling populer. Jika Anda ingin menghubungkan knowledge base dengan workflow agent, pelajari coaching AI Agent untuk bisnis.
FAQ
Pertanyaan yang sering ditanyakan
Kenapa RAG harus dimulai dari document inventory?
Karena kualitas jawaban AI bergantung pada kualitas dan relevansi dokumen yang tersedia. Model tidak bisa memperbaiki dokumen yang berantakan.
Apa kesalahan paling umum saat chunking dokumen SOP?
Memecah dokumen semata per jumlah karakter sehingga konteks aturan, pengecualian, dan langkah prosedur terpotong tidak logis.
Mengapa banyak tim memilih pgvector?
Karena mudah diintegrasikan ke PostgreSQL yang sudah familiar, sehingga arsitektur awal RAG lebih sederhana dan mudah diaudit.
Apa fungsi audit log dalam sistem RAG?
Untuk melacak pertanyaan, sumber chunk, skor retrieval, dan jawaban akhir sehingga kesalahan bisa ditelusuri dan diperbaiki.
Apakah RAG otomatis membuat AI bebas halusinasi?
Tidak. RAG hanya memberi konteks lebih baik. Anda tetap membutuhkan policy jawaban, metadata, QA, dan audit log.
Bagaimana mengatur akses agar dokumen sensitif tidak bocor?
Gunakan metadata peran atau departemen, filter retrieval berdasarkan akses pengguna, dan batasi koleksi dokumen yang boleh dipakai per use case.
Tentang penulis
Leon Kwan
AI Agent Business Coach dan praktisi digital marketing yang membantu founder serta tim perusahaan membangun otomasi yang terukur, aman, dan dapat diwariskan ke tim internal.
Lihat profil Leon Kwan →Lanjut membaca
Artikel terkait
Bagikan artikel ini ke founder, COO, atau tim implementasi Anda.