self-hosted AI agent untuk perusahaan
Self-Hosted AI Agent: Kapan Local LLM Cocok untuk Bisnis?
Jawaban langsung: Self-hosted AI Agent cocok untuk perusahaan yang membutuhkan kontrol data, kebijakan akses ketat, dan arsitektur inference yang bisa dijalankan di lingkungan sendiri. Keputusan utamanya ada pada sizing hardware, throughput, dan governance.
Panduan pembaca
Istilah penting dalam artikel ini
- Local LLM
- Large Language Model yang dijalankan di server atau perangkat milik sendiri, bukan layanan cloud publik.
- Inference
- Proses ketika model menjalankan input dan menghasilkan output.
- Throughput
- Jumlah request atau token yang dapat diproses sistem dalam periode tertentu.
- Concurrency
- Jumlah request yang dapat dilayani secara bersamaan.
- GPU
- Graphics Processing Unit yang sering dipakai untuk mempercepat perhitungan model AI.
Bagikan artikel ini ke founder, COO, atau tim implementasi Anda.
Data privat
Data sensitif tetap berada dalam boundary yang disepakati.
Kapasitas terukur
Model dipilih berdasarkan beban dan SLA nyata.
Access audit
Akses dan perubahan tercatat untuk pemeriksaan.
- Klasifikasikan data dan risiko sebelum memilih local LLM.
- Hitung kebutuhan latency, concurrency, GPU, storage, dan fallback.
- Pisahkan akses operator, service account, dan data sensitif.
- Siapkan monitoring kapasitas, patching, backup, dan incident response.
Privasi bukan hanya soal server berada di kantor; privasi juga ditentukan oleh siapa yang boleh mengakses, menyimpan, dan mengaudit datanya.
Jawaban singkat
Self-hosted AI Agent cocok untuk perusahaan yang membutuhkan kontrol data, kebijakan akses ketat, dan arsitektur inference yang bisa dijalankan di lingkungan sendiri. Keputusan utamanya ada pada sizing hardware, throughput, dan governance.
Local LLM dan self-hosted AI Agent biasanya muncul dalam percakapan ketika perusahaan mulai gelisah terhadap dua hal: data sensitif dan biaya inference yang sulit diprediksi. Tidak semua bisnis perlu self-host.
Namun untuk organisasi yang memproses kontrak, harga khusus, dokumen internal, atau data pelanggan yang ketat, pertanyaan tentang data residency dan kontrol akses memang menjadi serius.
Di titik inilah diskusi harus bergeser dari model mana paling pintar menjadi arsitektur mana paling masuk akal untuk risiko dan volume kita.
Keputusan pertama adalah memahami pola beban kerja. Apakah agent Anda akan melayani pertanyaan singkat dengan banyak concurrency?
Apakah ia akan membaca dokumen panjang? Apakah ia bekerja real-time di WhatsApp, atau lebih sering membantu staf internal secara batch?
Jawaban ini menentukan sizing hardware. Banyak tim terlalu cepat membeli GPU besar karena takut kekurangan tenaga, padahal bottleneck utama bisa saja ada pada context length, pipeline retrieval, atau orkestrasi request.
Memilih inference engine
Untuk tahap awal, Ollama sering cocok sebagai jalur prototyping dan eksperimen lokal karena pemasangan relatif cepat dan ergonomis untuk tim yang baru mencoba local inference.
Namun ketika beban mulai meningkat, tim sering memerlukan serving layer yang lebih serius seperti vLLM karena efisiensi batching, throughput, dan kontrol deployment yang lebih baik.
Memilih antara Ollama dan vLLM bukan pertarungan ideologis; itu soal fase organisasi.
Gateway, privacy, dan kontrol akses
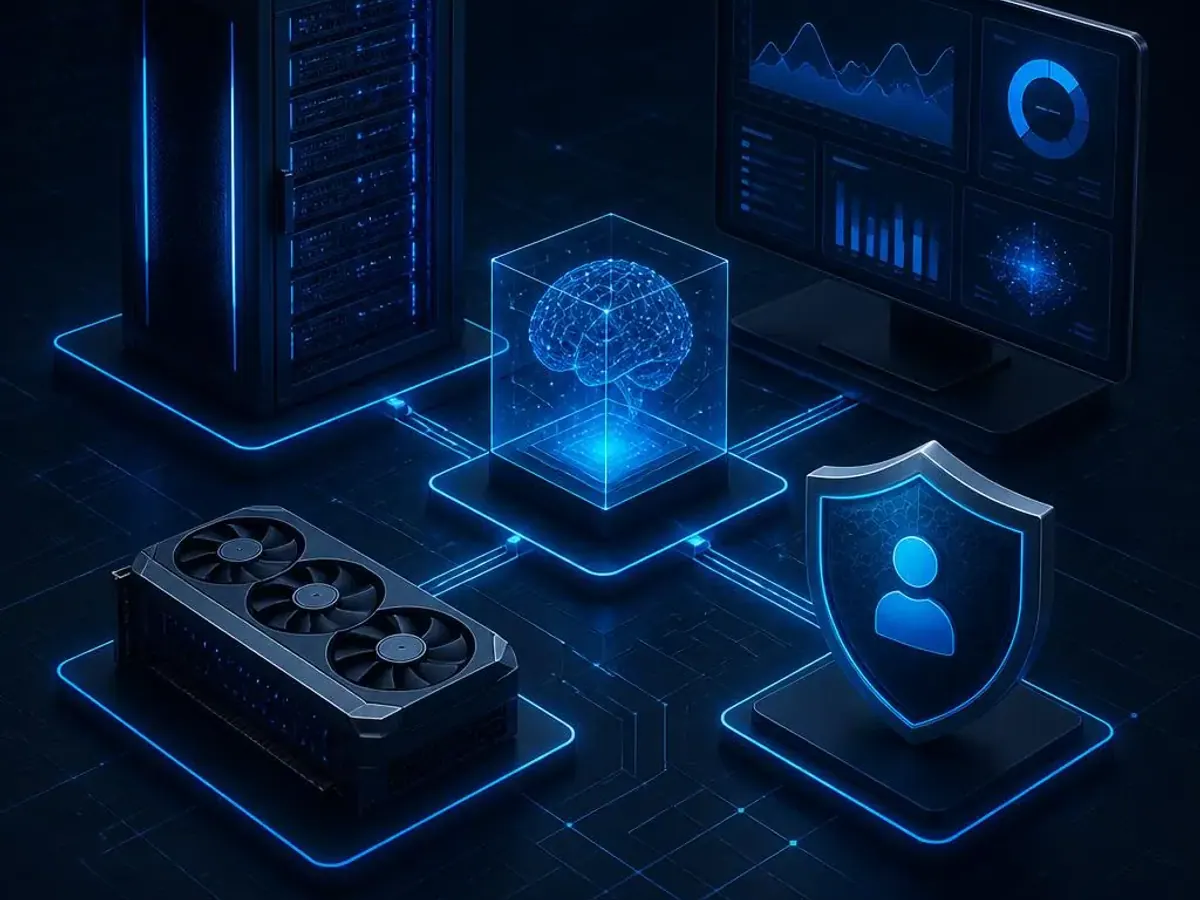
Dalam arsitektur on-premise, inference server sebaiknya tidak berdiri sendirian. Anda membutuhkan gateway internal yang mengatur autentikasi, rate limiting, logging, dan policy penggunaan.
Dengan gateway seperti ini, permintaan dari aplikasi internal tidak langsung menabrak model. Anda bisa menentukan siapa yang boleh memanggil model tertentu, siapa yang boleh mengirim dokumen sensitif, dan skenario mana yang wajib melalui retrieval atau masking.
Data residency bukan sekadar slogan data tetap di server sendiri. Artinya Anda benar-benar tahu di mana dokumen disimpan, siapa yang bisa mengakses, bagaimana backup dilakukan, dan bagaimana log disanitasi.
Banyak organisasi self-host model tetapi tetap lalai menyimpan prompt sensitif ke log tanpa redaksi. Ini berbahaya.
Privacy engineering harus masuk ke desain sejak awal: token masking, segregasi akses, enkripsi at-rest untuk data penting, dan runbook jika terjadi insiden.
Sizing GPU juga perlu dilihat secara ekonomi, bukan hanya teknis. Untuk beberapa use case, latency subdetik tidak diperlukan.
Jika SLA Anda masih aman di rentang beberapa detik, konfigurasi hardware bisa jauh lebih efisien. Sebaliknya, jika AI Agent berada di jalur customer-facing dan harus merespons cepat dengan context cukup panjang, Anda perlu mempertimbangkan kapasitas memori GPU, model quantization, dan strategi batching.
Arsitektur modular dan hybrid
Saya menyarankan arsitektur on-premise dibangun modular:
- Ingress atau gateway.
- Retrieval atau policy engine jika perlu.
- Inference server.
- Audit log serta observability.
Dengan pemisahan ini, Anda bisa mengganti model atau engine tanpa membongkar seluruh aplikasi. Modularitas juga penting saat tim ingin menguji model baru, mengubah quantization, atau memindahkan sebagian workload ke cloud untuk use case non-sensitif.
Self-host bukan berarti semua hal harus 100 persen lokal. Banyak perusahaan justru paling sehat dengan arsitektur hybrid.
Dokumen sensitif, knowledge base internal, dan workflow tertentu diproses lokal. Sementara aktivitas non-sensitif seperti drafting konten publik atau tugas analitis ringan tetap bisa memakai cloud bila lebih efisien.
Pendekatan hybrid seperti ini menghindarkan bisnis dari dua ekstrem: terlalu takut pada cloud atau terlalu tergantung pada cloud.
Nilai strategis self-hosted AI Agent bukan cuma keamanan. Ia juga memberi kontrol pada roadmap.
Anda bisa menentukan kapan model di-upgrade, kapan prompt library diubah, bagaimana caching bekerja, dan bagaimana quota dibagi antar departemen. Semua keputusan ini membantu organisasi menjadikan AI sebagai infrastruktur, bukan sekadar langganan aplikasi.
Namun self-host juga menuntut kedewasaan operasi. Jika tim Anda belum siap memantau server, log, backup, dan insiden, maka local LLM bisa berubah menjadi biaya baru yang tidak memberikan nilai.
Karena itu, keputusan self-host harus dilihat sebagai keputusan operasi dan tata kelola, bukan sekadar keputusan teknologi.
Sebelum go-live, siapkan secret management, pemisahan environment development dan production, masking pada log prompt, serta prosedur patching model atau engine. Data residency harus diperiksa sepanjang alur—storage, embedding, backup, dan log—bukan hanya dari lokasi inference server.
Perbandingan Opsi Deployment
| Opsi | Kelebihan | Keterbatasan | Kapan cocok |
|---|---|---|---|
| SaaS/cloud penuh | Cepat mulai, sedikit beban infra | Kontrol data lebih rendah | Use case non-sensitif |
| Ollama lokal | Cepat prototyping, setup ringan | Kurang optimal untuk beban produksi tinggi | POC dan tim kecil |
| vLLM produksi | Throughput lebih baik, cocok serving | Butuh infra dan operasi lebih matang | Use case produksi berulang |
| Arsitektur hybrid | Kontrol risiko dan biaya lebih fleksibel | Desain governance lebih kompleks | Perusahaan dengan data campuran |
Skenario arsitektur on-premise
Bayangkan sebuah perusahaan distribusi dengan data harga khusus, margin per mitra, dan draft kontrak yang tidak boleh keluar ke layanan publik. Mereka ingin membangun asisten internal untuk sales dan ops.
Solusi yang masuk akal bukan langsung menaruh semua data ke cloud, melainkan membangun gateway internal, menyimpan dokumen di storage yang dikontrol perusahaan, lalu menjalankan inference lokal untuk pertanyaan yang menyentuh informasi sensitif.
Untuk kebutuhan yang sifatnya umum, mereka tetap bisa mempertimbangkan jalur cloud terpisah dengan data yang disanitasi.
Dalam skenario seperti ini, CTO tidak perlu mengejar model terbesar. Fokusnya adalah memastikan throughput cukup untuk jumlah pengguna internal, latency masih nyaman, log aman, dan fallback tersedia jika node inference bermasalah.
Dengan desain modular, perusahaan bisa mulai dari satu server inference, lalu menambah kapasitas ketika use case dan adopsi benar-benar tumbuh.
Contoh evaluasi ekonomi self-hosted
| Komponen | Pertanyaan | Contoh hitung | Makna |
|---|---|---|---|
| CAPEX hardware | Berapa umur pakai server/GPU? | Amortisasi per 24–36 bulan | Bandingkan dengan volume inference |
| OPEX operasi | Siapa memonitor dan backup? | Jam kerja infra per bulan | Masuk biaya kepemilikan total |
| Biaya inference cloud yang dihindari | Volume token sensitif per bulan | Hitung sesuai penggunaan riil | Bukan asumsi umum |
| Manfaat utama | Kontrol data dan kebijakan | Nilai non-finansial besar | Penting untuk compliance |
Framework implementasi
- Definisikan use case sensitif dan non-sensitif, lalu pilih apakah deployment penuh lokal atau hybrid lebih masuk akal.
- Ukur kebutuhan concurrency, context length, dan target latency untuk menentukan sizing GPU secara rasional.
- Bangun gateway, logging, access control, dan masking sebelum model diekspos ke banyak pengguna.
- Siapkan runbook operasi: monitoring, backup, patching, dan prosedur fallback bila inference server bermasalah.
Kesimpulan
Self-hosted AI Agent masuk akal ketika kontrol data dan kebijakan akses sepadan dengan beban operasi yang harus diambil alih tim internal. Mulailah dari workload dan risiko nyata, lalu pilih Ollama, vLLM, atau arsitektur hybrid berdasarkan kapasitas yang terukur—bukan asumsi benchmark.
Untuk menilai kesiapan use case dan governance AI Agent di perusahaan Anda, Anda dapat melihat coaching AI Agent.
FAQ
Pertanyaan yang sering ditanyakan
Kapan local LLM lebih masuk akal daripada cloud?
Saat data sensitif, kebutuhan kontrol akses tinggi, atau pola penggunaan cukup besar sehingga kontrol biaya dan data residency menjadi prioritas utama.
Apa beda utama Ollama dan vLLM?
Ollama cocok untuk prototyping dan setup cepat, sedangkan vLLM lebih cocok untuk serving produksi yang membutuhkan throughput dan efisiensi lebih baik.
Bagaimana cara mulai sizing GPU?
Mulai dari kebutuhan bisnis: jumlah request, panjang konteks, target latency, dan concurrency. Jangan membeli hardware besar hanya karena benchmark generik.
Apakah self-host berarti semua hal harus lokal?
Tidak. Banyak perusahaan lebih sehat memakai arsitektur hybrid: workload sensitif lokal, workload umum tetap di cloud.
Apa risiko utama self-hosted AI Agent?
Beban operasi: monitoring, backup, keamanan log, patching, dan tanggung jawab uptime berpindah ke tim internal.
Bagaimana menjaga privasi data pada local LLM?
Gunakan gateway, masking data sensitif, kontrol akses per peran, enkripsi penyimpanan penting, dan audit log yang terkelola dengan baik.
Tentang penulis
Leon Kwan
AI Agent Business Coach dan praktisi digital marketing yang membantu founder serta tim perusahaan membangun otomasi yang terukur, aman, dan dapat diwariskan ke tim internal.
Lihat profil Leon Kwan →Lanjut membaca
Artikel terkait
Bagikan artikel ini ke founder, COO, atau tim implementasi Anda.